퍼플렉서티: 각 단어가 얼마나 의외인가
퍼플렉서티는 언어 모델이 다음 단어를 얼마나 잘 예측하는지를 나타내요. AI가 만든 글은 퍼플렉서티가 낮은 경향이 있어요. 글을 쓴 모델이 나올 법한 단어를 골랐으니까요. 사람의 글은 보통 더 높아요. 특이한 단어 선택, 관용구, 농담, 오타가 있으니까요.
이게 가장 큰 약점이기도 해요. 단순하거나 격식 있거나 교과서 같은 사람의 글도 퍼플렉서티가 낮을 수 있고, 같은 이유로 판정을 받아요.
버스티니스: 리듬이 얼마나 바뀌는가
버스티니스는 문서 전체의 변화를 봐요. 사람은 긴 문장을 쓰고 나서 짧은 문장을 써요. 빽빽한 문단 다음에 가벼운 문단을 두죠. 모델은 일정한 리듬을 유지하는 경향이 있어요.
탐지기는 두 지표를 함께 써요. 퍼플렉서티도 버스티니스도 낮은 글이 가장 기계처럼 보여요.
예시로 학습한 분류기
Turnitin, GPTZero, Copyleaks를 비롯한 대부분의 상용 탐지기는 한 걸음 더 나아가, 라벨을 붙인 사람과 AI의 글을 대량으로 학습한 분류기를 써요. 분류기는 즐겨 쓰는 표현이나 문단 구조처럼 퍼플렉서티 너머의 패턴도 배워요.
그래서 학습한 종류의 글에는 강하고, 그 밖의 글에는 약해요. 새 모델, 다른 언어, 기술 문서, 제2외국어로 쓴 글 같은 것들이요.
AI 탐지기를 믿기 어려운 이유
탐지는 움직이는 과녁을 쫓는 일이에요. 새 모델마다 글 쓰는 방식이 다르고, 탐지기는 따라잡아야 해요. 편집도 신호를 흐려요. 사람이 AI 초안의 일부를 다시 쓰면 그 글은 정말로 섞인 글이 되니까요.
더 큰 문제는 오탐이에요. 2023년 Stanford 연구에서는 탐지기 7개가 영어가 모국어가 아닌 사람들의 TOEFL 에세이 절반 이상을 AI가 쓴 것으로 잘못 분류했어요. 13만 5,000쌍이 넘는 문서를 분석한 2026년 프리프린트에서는 탐지기 13개의 오탐률이 0%에서 100%까지 제각각이었어요.
AI 탐지기 현명하게 쓰기
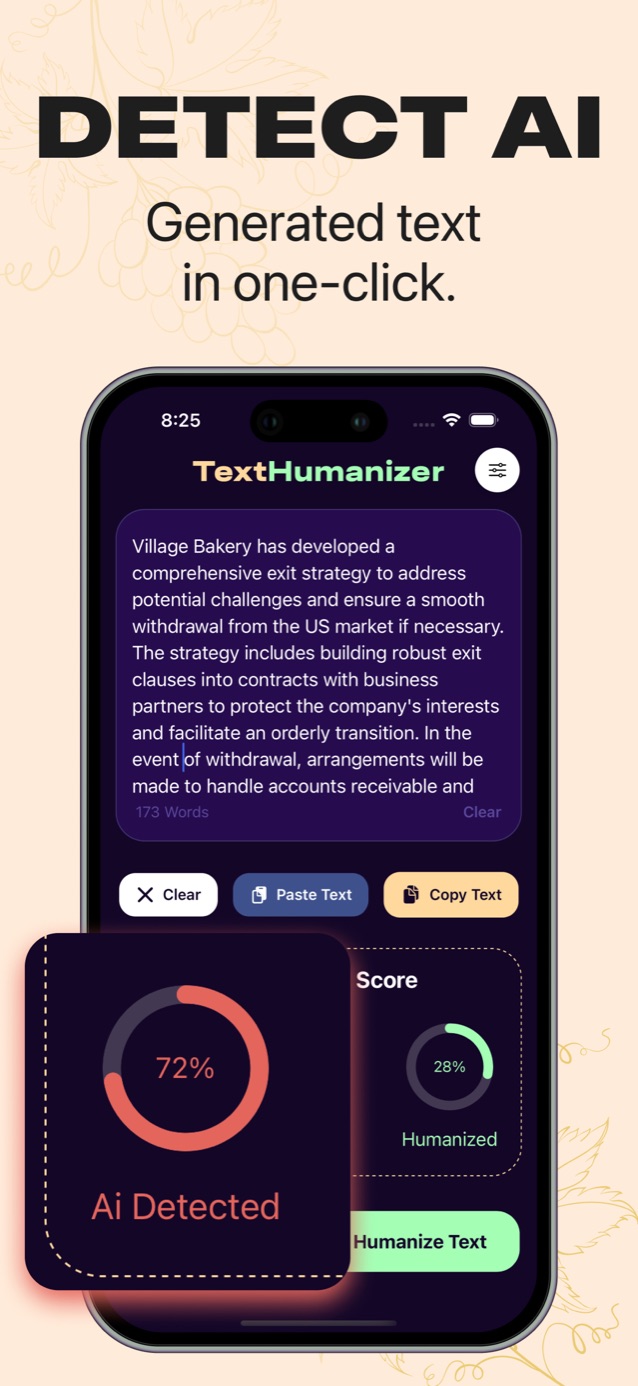
탐지기 점수는 어느 부분이 예측 가능하게 읽히는지 가리키는 표시로 쓸 때 가장 유용해요. TextHumanizer의 ‘Check for AI’는 어떤 문단이든 그 점수를 보여주고, ‘Humanize Text’는 밋밋한 부분을 다시 써서 전후를 비교할 수 있게 해줘요.
질문
AI 탐지기는 모든 AI 모델을 탐지할 수 있나요?
아니요. 특정 모델의 출력으로 학습하기 때문에 새로 나온 모델에는 뒤처져요. 학습 데이터에 드물었던 언어나 문체에서도 정확도가 떨어져요.
AI 탐지기가 내 글을 저장하나요?
도구마다 달라요. 모델 개선을 위해 제출물을 보관하는 곳도 있으니, 민감한 글을 붙여넣기 전에 개인정보 처리방침을 확인하세요.