困惑度:每个词有多出人意料
困惑度衡量的是语言模型预测下一个词的准确程度。AI生成的文字困惑度往往偏低,因为写它的模型挑的都是可能性高的词。人写的文字困惑度通常更高:不常见的用词、俗语、一句玩笑、一个错别字。
这也是它最大的弱点。简单、正式或教科书式的真人写作困惑度同样可能很低,也会因为同样的原因被标记。
突发性:节奏变化有多大
突发性看的是整篇文字内部的变化。人会先写一个长句,再接一个短句;一段密集的内容后面跟一段轻松的。模型则倾向于保持稳定的节奏。
检测器会把这两个指标结合起来。困惑度低、突发性也低的文字,看起来最像机器写的。
用样本训练出来的分类器
大多数商业检测器,包括 Turnitin、GPTZero 和 Copyleaks,会更进一步,用大量标注好的真人和AI写作来训练分类器。分类器能学到困惑度之外的模式,比如偏爱的说法和段落结构。
这让它们在训练过的文字类型上表现更好,遇到不一样的就会变差:新模型、其他语言、技术写作,或者用第二语言写作的人写的东西。
为什么AI检测器不可靠
检测的对象一直在变。每个新模型的写法都不同,检测器只能不断追赶。修改也会让信号变得模糊:一旦有人改写了AI初稿的一部分,这段文字就真正成了混合体。
误判是更大的问题。Stanford 2023年的一项研究发现,七款检测器把一组非英语母语者写的 TOEFL 作文中一半以上误判为AI写作。2026年一篇分析了超过135,000组文档的预印本论文发现,13款检测器的误判率从0%到100%不等。
理性使用AI检测工具
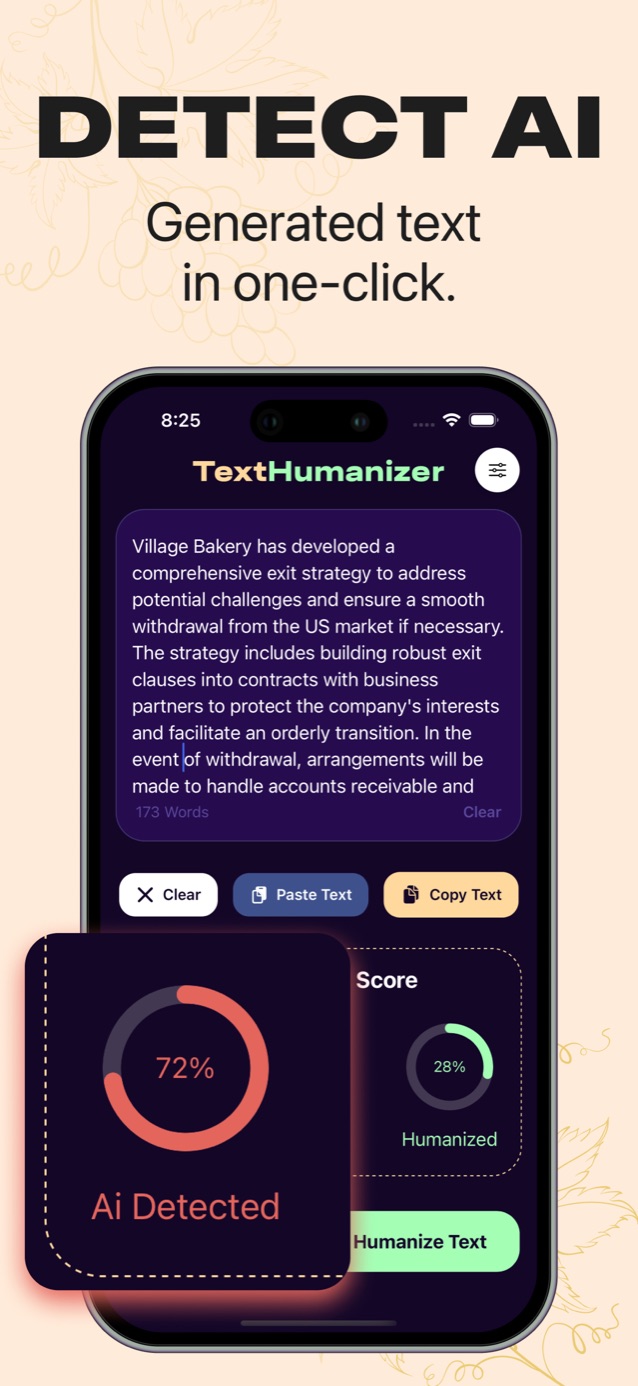
检测分数最有用的地方是当作指针:它告诉你哪些段落读起来太好预测。TextHumanizer 的“Check for AI”能给任何段落打出这个分数,“Humanize Text”则会改写平淡的部分,方便你对比前后的变化。
常见问题
AI检测器能识别所有AI模型吗?
不能。它们是用特定模型的输出训练的,总是落后于新发布的模型。对于训练数据中少见的语言和写作风格,准确率也会下降。
AI检测器会保存我的文字吗?
取决于具体工具。有些会保留提交的内容来改进模型,所以粘贴敏感内容之前,先看看检测器的隐私政策。