Perplexität: Wie überraschend jedes Wort ist
Die Perplexität misst, wie gut ein Sprachmodell das nächste Wort vorhersagen kann. KI-Text hat meist eine niedrige Perplexität, weil das Modell, das ihn geschrieben hat, wahrscheinliche Wörter gewählt hat. Menschliche Texte haben meist eine höhere: ungewöhnliche Wortwahl, Redewendungen, ein Witz, ein Tippfehler.
Genau hier liegt auch die größte Schwäche. Einfache, formelle oder lehrbuchhafte menschliche Texte können ebenfalls eine niedrige Perplexität haben und werden aus demselben Grund markiert.
Burstiness: Wie stark sich der Rhythmus ändert
Burstiness beschreibt die Abwechslung innerhalb eines Dokuments. Menschen schreiben einen langen Satz, dann einen kurzen. Auf einen dichten Absatz folgt ein leichter. Modelle halten eher einen gleichmäßigen Rhythmus.
Detektoren kombinieren beide Werte. Text mit niedriger Perplexität und niedriger Burstiness wirkt am stärksten maschinell.
Probier es mit deinem eigenen Text
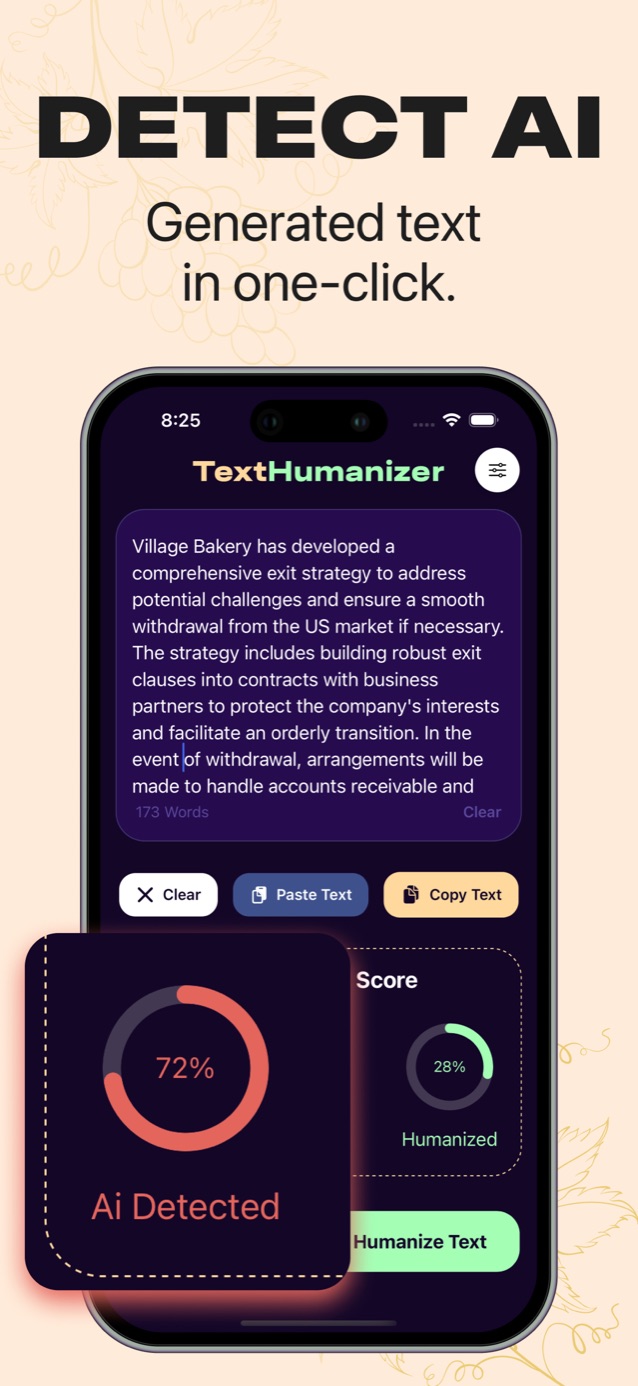
Füge einen Absatz ein und sieh deinen KI-Score vorher und nachher.
Jeden Absatz mit einem Tipp auf KI prüfen. Die Screenshots zeigen die englische Oberfläche.
Im App Store ladenKlassifikatoren, mit Beispielen trainiert
Die meisten kommerziellen Detektoren, darunter Turnitin, GPTZero und Copyleaks, gehen weiter und trainieren einen Klassifikator mit großen Mengen gekennzeichneter menschlicher und KI-Texte. Der Klassifikator lernt Muster über die Perplexität hinaus, etwa Lieblingsformulierungen und Absatzaufbau.
Dadurch sind sie besser bei den Textarten, mit denen sie trainiert wurden, und schlechter bei allem anderen: neue Modelle, andere Sprachen, Fachtexte oder Texte von Menschen, die in einer Zweitsprache schreiben.
Warum KI-Detektoren unzuverlässig sind
Erkennung ist ein bewegliches Ziel. Jedes neue Modell schreibt anders, und Detektoren müssen nachziehen. Auch Überarbeitung verwischt das Signal: Sobald ein Mensch einen Teil eines KI-Entwurfs umschreibt, ist der Text tatsächlich gemischt.
Das größere Problem sind Fehlalarme. Eine Stanford-Studie von 2023 ergab, dass sieben Detektoren mehr als die Hälfte einer Reihe von TOEFL-Aufsätzen von Nicht-Muttersprachlern fälschlich als KI-geschrieben einstuften. Ein Preprint von 2026, der mehr als 135.000 Dokumentpaare analysierte, fand bei 13 Detektoren Fehlalarm-Quoten zwischen 0 % und 100 %.
Einen KI-Checker sinnvoll nutzen
Ein Detektor-Score ist als Wegweiser am nützlichsten: Er zeigt dir, welche Passagen vorhersagbar wirken. „Check for AI“ in TextHumanizer liefert dir diesen Score für jeden Absatz, und „Humanize Text“ schreibt die flachen Stellen um, damit du vorher und nachher vergleichen kannst.
Fragen
Können KI-Detektoren jedes KI-Modell erkennen?
Nein. Sie sind mit der Ausgabe bestimmter Modelle trainiert und hinken neuen Versionen hinterher. Auch bei Sprachen und Schreibstilen, die in ihren Trainingsdaten selten waren, sinkt die Genauigkeit.
Speichern KI-Detektoren meinen Text?
Das hängt vom Tool ab. Manche behalten Einsendungen, um ihre Modelle zu verbessern. Lies also die Datenschutzerklärung eines Detektors, bevor du sensible Texte einfügst.