パープレキシティ:各単語がどれだけ意外か
パープレキシティは、言語モデルが次の単語をどれだけうまく予測できるかを表す指標です。AIが作った文章は、書いたモデル自身が出やすい単語を選んでいるので、パープレキシティが低くなりがちです。人の文章はふつう高めです。珍しい言葉選び、慣用句、冗談、誤字などがあるからです。
これが最大の弱点でもあります。シンプルな文章、フォーマルな文章、教科書のような文章は、人が書いてもパープレキシティが低くなり、同じ理由で判定されてしまいます。
バースティネス:リズムがどれだけ変わるか
バースティネスは、文書全体のばらつきを見る指標です。人は長い文のあとに短い文を書きます。密度の高い段落のあとに軽い段落を置きます。モデルは一定のリズムを保ちがちです。
AI検出ツールはこの2つを組み合わせます。パープレキシティもバースティネスも低い文章が、いちばん機械っぽく見えます。
例から学習した分類器
Turnitin、GPTZero、Copyleaksなど多くの商用ツールは、さらに一歩進んで、ラベル付きの人とAIの文章を大量に使って分類器を学習させています。分類器は、決まり文句や段落の組み立てなど、パープレキシティ以外のパターンも学びます。
そのため、学習した種類の文章には強く、それ以外には弱くなります。新しいモデル、ほかの言語、技術的な文章、第2言語で書く人の文章などです。
AI検出ツールが当てにならない理由
検出は動く的を追うようなものです。新しいモデルはそれぞれ書き方が違い、検出ツールはそれに追いつかなければなりません。編集も信号をぼやけさせます。人がAIの下書きの一部を書き直せば、その文章は本当に人とAIが混ざったものになります。
より大きな問題は誤判定です。2023年のStanfordの研究では、7つの検出ツールが、英語を母語としない人のTOEFLエッセイの半分以上をAIが書いたものと誤って分類しました。13万5,000組以上の文書を分析した2026年のプレプリントでは、13の検出ツールで誤判定率が0%から100%までばらついていました。
AIチェッカーを賢く使う
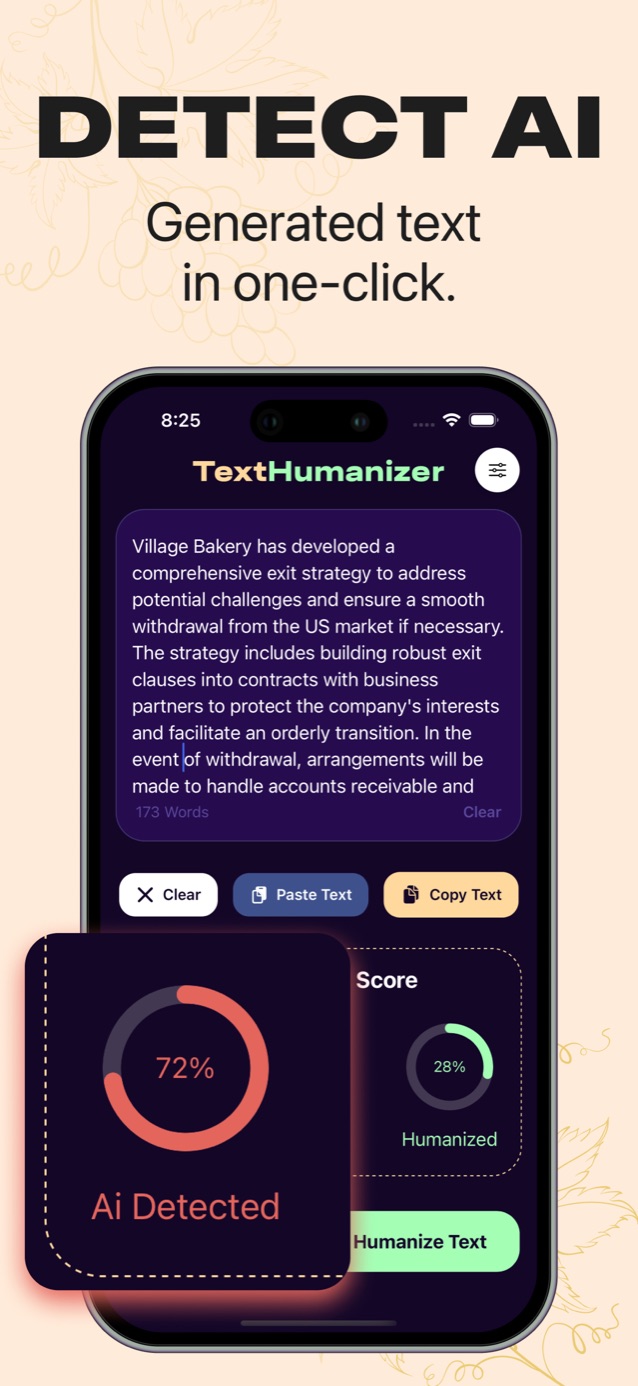
検出スコアは、どの部分が予測しやすく読めるかを指し示す目印として使うのがいちばん役立ちます。TextHumanizerの「Check for AI」はどの段落でもそのスコアを出し、「Humanize Text」が平板な部分を書き直すので、前後を比べられます。
よくある質問
AI検出ツールはすべてのAIモデルを検出できますか?
いいえ。特定のモデルの出力で学習しているため、新しいモデルには遅れをとります。学習データに少なかった言語や文体でも精度が下がります。
AI検出ツールは私の文章を保存しますか?
ツールによります。モデル改善のために提出内容を保存するものもあるので、大切な文章を貼り付ける前にプライバシーポリシーを確認しましょう。