Perplexity: sejauh mana setiap perkataan mengejutkan
Perplexity mengukur sejauh mana model bahasa dapat meramal perkataan seterusnya. Teks yang dihasilkan AI cenderung mempunyai perplexity rendah, kerana model yang menulisnya memilih perkataan yang berkemungkinan. Tulisan manusia biasanya mempunyai perplexity lebih tinggi: pilihan perkataan yang luar biasa, simpulan bahasa, jenaka, salah taip.
Di sinilah kelemahan utamanya. Tulisan manusia yang ringkas, formal atau bergaya buku teks juga boleh mempunyai perplexity rendah, dan ia ditanda atas sebab yang sama.
Burstiness: sejauh mana rentaknya berubah
Burstiness melihat variasi di sepanjang dokumen. Manusia menulis ayat panjang, kemudian ayat pendek. Perenggan yang padat diikuti perenggan yang ringan. Model AI cenderung mengekalkan rentak yang tetap.
Pengesan menggabungkan kedua-dua ukuran ini. Teks dengan perplexity rendah dan burstiness rendah kelihatan paling seperti mesin.
Cuba dengan teks anda sendiri
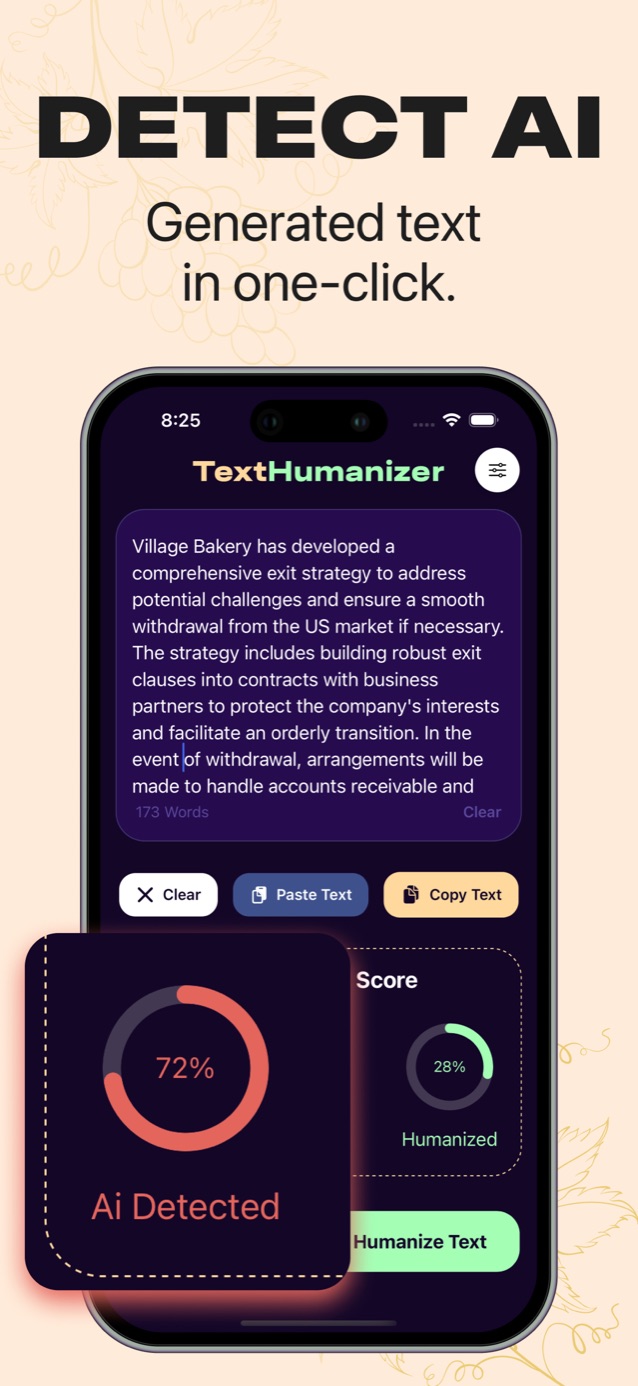
Tampal satu perenggan dan lihat skor AI anda sebelum dan selepas.
Semak sebarang perenggan untuk AI dengan satu ketikan. Tangkapan skrin memaparkan antara muka bahasa Inggeris.
Muat turun di App StorePengelas yang dilatih dengan contoh
Kebanyakan pengesan komersial, termasuk Turnitin, GPTZero dan Copyleaks, pergi lebih jauh dengan melatih pengelas menggunakan set besar tulisan manusia dan AI yang berlabel. Pengelas itu mempelajari corak di luar perplexity, seperti frasa kegemaran dan struktur perenggan.
Ini menjadikannya lebih baik pada jenis teks yang digunakan untuk melatihnya dan lebih lemah pada apa-apa yang berbeza: model baharu, bahasa lain, penulisan teknikal atau tulisan orang yang menggunakan bahasa kedua.
Mengapa pengesan AI tidak boleh dipercayai
Pengesanan ialah sasaran yang sentiasa bergerak. Setiap model baharu menulis dengan cara berbeza, dan pengesan terpaksa mengejar. Suntingan juga mengaburkan isyarat: sebaik sahaja seseorang menulis semula sebahagian draf AI, teks itu benar-benar bercampur.
Positif palsu ialah masalah yang lebih besar. Kajian Stanford pada 2023 mendapati tujuh pengesan tersilap mengelaskan lebih separuh daripada satu set esei TOEFL oleh penutur bukan asli bahasa Inggeris sebagai tulisan AI. Satu pracetak 2026 yang menganalisis lebih 135,000 pasangan dokumen mendapati kadar positif palsu antara 0% hingga 100% merentas 13 pengesan.
Menggunakan pengesan AI dengan bijak
Skor pengesan paling berguna sebagai penunjuk arah: ia memberitahu petikan mana yang berbunyi mudah diramal. Ciri “Check for AI” dalam TextHumanizer memberi skor itu bagi sebarang perenggan, dan “Humanize Text” menulis semula bahagian yang hambar supaya anda boleh membandingkan sebelum dan selepas.
Soalan
Bolehkah pengesan AI mengesan semua model AI?
Tidak. Ia dilatih dengan output daripada model tertentu dan ketinggalan berbanding keluaran baharu. Ketepatan juga menurun bagi bahasa dan gaya penulisan yang jarang terdapat dalam data latihannya.
Adakah pengesan AI menyimpan teks saya?
Ia bergantung pada alat tersebut. Sesetengahnya menyimpan teks yang dihantar untuk menambah baik model mereka, jadi semak dasar privasi mana-mana pengesan sebelum menampal kerja yang sensitif.