Perpleksisyys: kuinka yllättävä kukin sana on
Perpleksisyys mittaa, kuinka hyvin kielimalli pystyy ennustamaan seuraavan sanan. Tekoälyn tekstin perpleksisyys on yleensä matala, koska sen kirjoittanut malli valitsi todennäköisiä sanoja. Ihmisen tekstin perpleksisyys on tavallisesti korkeampi: epätavallisia sanavalintoja, sanontoja, vitsi, kirjoitusvirhe.
Tämä on myös menetelmän suurin heikkous. Yksinkertaisen, muodollisen tai oppikirjamaisen ihmistekstin perpleksisyys voi olla yhtä lailla matala, ja se merkitään samasta syystä.
Purskeisuus: kuinka paljon rytmi vaihtelee
Purskeisuus tarkastelee vaihtelua koko tekstin läpi. Ihminen kirjoittaa pitkän lauseen ja sitten lyhyen. Tiivistä kappaletta seuraa kevyempi. Mallit pitävät yleensä rytmin tasaisena.
Tunnistimet yhdistävät molemmat mittarit. Teksti, jonka perpleksisyys ja purskeisuus ovat matalia, näyttää koneellisimmalta.
Kokeile omalla tekstilläsi
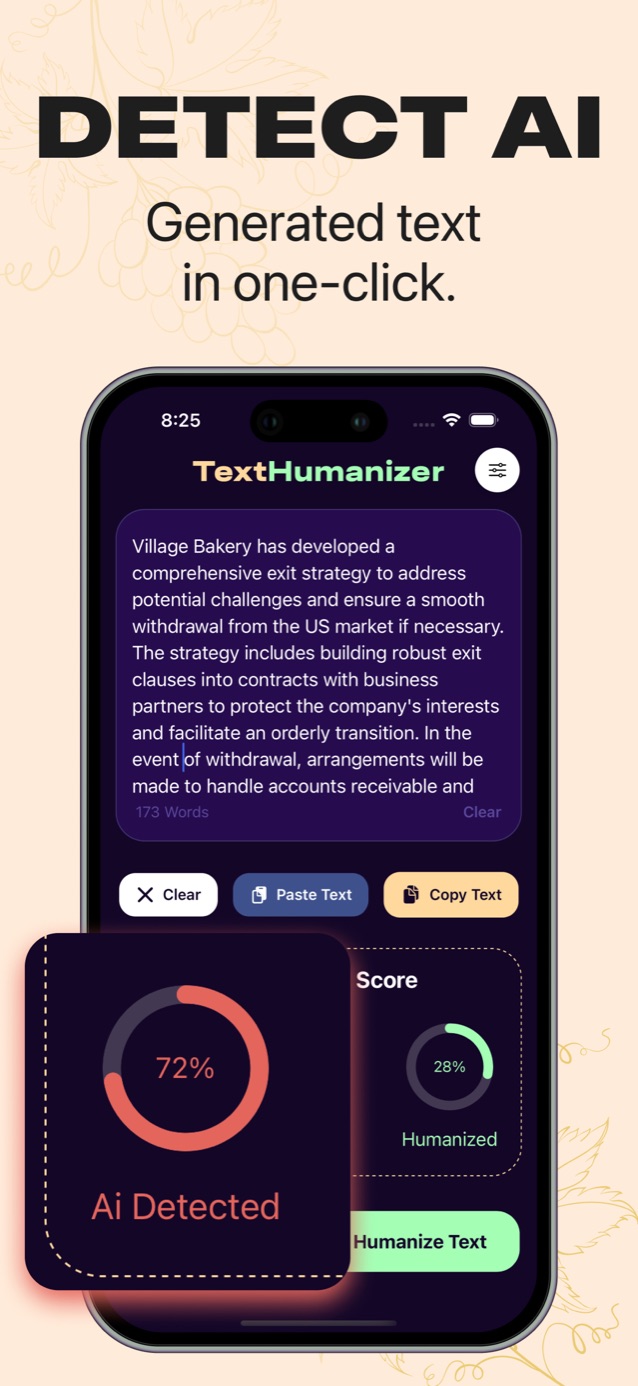
Liitä kappale ja näe AI-pisteesi ennen ja jälkeen.
Tarkista mikä tahansa kappale yhdellä napautuksella. Kuvakaappauksissa näkyy sovelluksen englanninkielinen käyttöliittymä.
Lataa App StorestaEsimerkeillä koulutetut luokittimet
Useimmat kaupalliset tunnistimet, kuten Turnitin, GPTZero ja Copyleaks, menevät pidemmälle ja kouluttavat luokittimen suurella määrällä merkittyä ihmisten ja tekoälyn tekstiä. Luokitin oppii perpleksisyyden lisäksi muitakin kaavoja, kuten lempifraaseja ja kappaleiden rakennetta.
Siksi ne toimivat paremmin sellaisessa tekstissä, jolla ne on koulutettu, ja huonommin kaikessa muussa: uusissa malleissa, muilla kielillä, teknisessä tekstissä tai vieraalla kielellä kirjoittavien teksteissä.
Miksi tekoälytunnistimet ovat epäluotettavia
Tunnistus on liikkuva maali. Jokainen uusi malli kirjoittaa eri tavalla, ja tunnistimien on pysyttävä perässä. Myös muokkaaminen sumentaa signaalia: kun ihminen kirjoittaa osan tekoälyluonnoksesta uudelleen, teksti on aidosti sekoitettua.
Väärät positiiviset ovat suurempi ongelma. Stanfordin vuoden 2023 tutkimuksessa seitsemän tunnistinta luokitteli yli puolet englantia vieraana kielenä kirjoittavien TOEFL-esseistä virheellisesti tekoälyn kirjoittamiksi. Vuoden 2026 preprint-tutkimus, joka analysoi yli 135 000 asiakirjaparia, löysi 13 tunnistimen väliltä väärien positiivisten osuuksia 0 %:sta 100 %:iin.
Tekoälytunnistimen järkevä käyttö
Tunnistimen tulos on hyödyllisin osoittimena: se kertoo, mitkä kohdat kuulostavat ennustettavilta. TextHumanizerin ”Check for AI” antaa tuloksen mille tahansa kappaleelle, ja ”Humanize Text” kirjoittaa latteat kohdat uudelleen, joten voit verrata ennen ja jälkeen.
Kysymyksiä
Tunnistavatko tekoälytunnistimet kaikki tekoälymallit?
Eivät. Ne on koulutettu tiettyjen mallien tekstillä ja jäävät jälkeen uusista julkaisuista. Tarkkuus heikkenee myös kielillä ja tyyleillä, joita niiden koulutusaineistossa oli vähän.
Tallentavatko tekoälytunnistimet tekstini?
Se riippuu työkalusta. Jotkin säilyttävät palautukset mallien parantamiseksi, joten tarkista tunnistimen tietosuojakäytäntö ennen kuin liität arkaluonteista tekstiä.